运行通义千问(Qwen)3.8 27B 模型需要多少 GPU 显存才能不损失质量。完整的 BF16 模型重 55 GB,超出多数消费级硬件。但 17 GB 的 Q4KM 在终端基准(Terminal-Bench)2.1 上媲美全模型,可放入英伟达(NVIDIA)RTX 4090 这类 24 GB 显卡,还能留约 64k tokens 上下文。压缩终有断崖:1 位时模型在 GPQA Diamond 上接近随机,更长推理更差。该模型 GGUF 量化提供 8 位 Q80(29 GB)、4 位 Q4KM(17 GB)、2 位 UD-Q2KXL(10.7 GB)与 1 位 UD-IQ1S(6.2 GB)等选项。
正文
运行 Qwen3.8 27B 到底需要多少 GPU 显存、又不牺牲太多质量?完整 BF16 权重有 55 GB,已经超出多数消费级硬件;但 17 GB 的 Q4KM 在一个流行的智能体编程基准 Terminal-Bench 2.1 上追平了完整模型。它装得进 24 GB 显存的 RTX 4090,还剩约 64k token 的上下文空间。压缩走到 1-bit 会撞上悬崖:模型在 GPQA Diamond 上接近随机猜测,而且推理越长越差。
背景
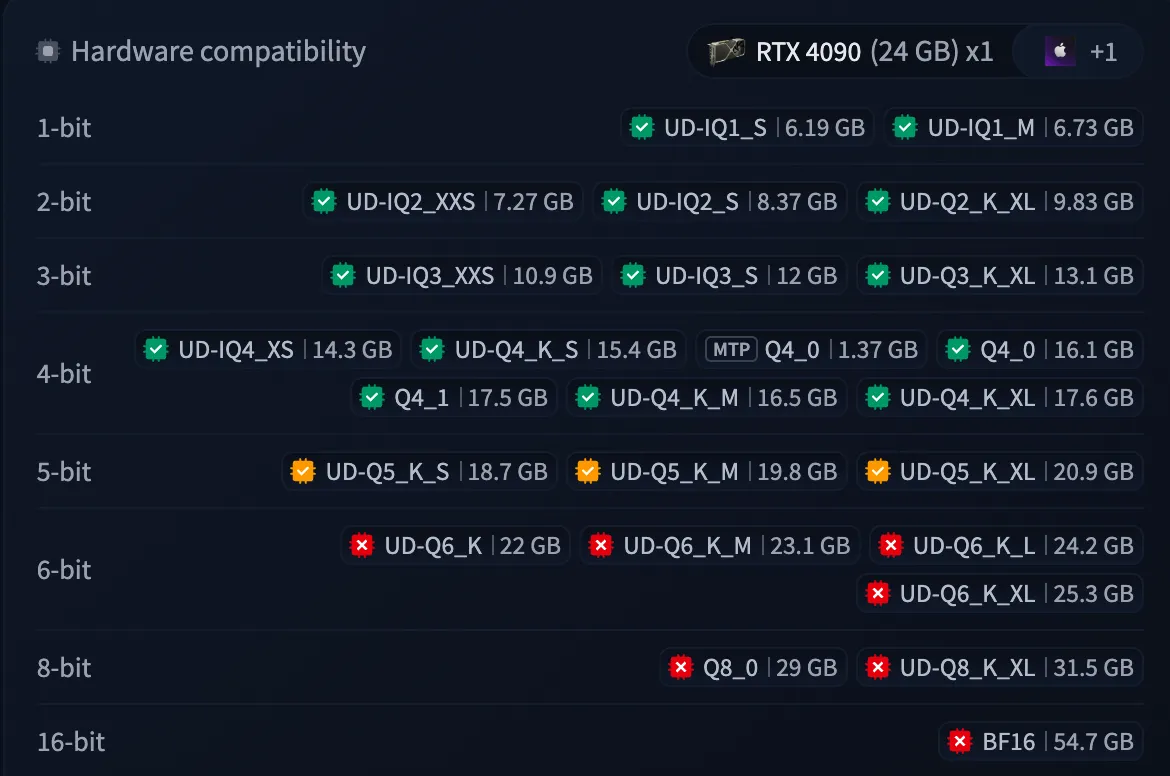
测试对象是 Unsloth 提供的四种量化:8-bit Q80(29 GB)、4-bit Q4KM(17 GB)、2-bit UD-Q2KXL(10.7 GB)以及最小的 1-bit UD-IQ1S(6.2 GB)。此前我测过 Qwen3.6 27B:12 GB 下仍能画出不错的 SVG 鹈鹕,知识能力到接近 16 GB 才明显下降。可是 Reddit 上不少人抱怨所有量化,甚至 8-bit,结果都更差。只看 token 预测的差异(KL 散度等)不够,量化模型可能只是换了种说法给出同样质量的答案,也可能一个不同的 token 就是逻辑错误或提前截断。所以我直接在三个流行基准上比较任务表现:GPQA Diamond、指令遵循 IFBench、编程 Terminal-Bench 2.1,先复现完整 BF16 模型的官方结果,再看量化带来的变化。
实验花了我约 3000 美元的 Modal GPU 机时,用 llama.cpp 跑。KV-cache 始终用 F16,与模型量化无关,每 32k token 约 2.3 GB。2/4/8-bit 用 Unsloth 的 v2 量化,1-bit 用 v3;后来 v2 文件被替换,多数测试用的确切文件已不可复现。简单说,4-bit 的 Q4KM(17 GB)在这几个基准上没有可见差异。但要留意 effort 设置(默认是 xhigh),它可能让模型过度思考。
单轮测试
最简单的是单轮任务:研究生水平的科学问答 GPQA Diamond 和指令遵循 IFBench。每个我都用 low、medium 和默认的 xhigh 三档推理强度跑。
GPQA Diamond
首先,我很高兴复现了官方结果:基准测试有一堆隐藏设置,第一次跑就得到 Qwen 报告的分数。其次,除了噪声,降到 4-bit 几乎没有差别,只有 2-bit 略低。思考强度对分数的影响很大,xhigh 跑出最好成绩需要约 8k 个推理 token。
IFBench
让我意外的是,模型之间几乎没有差异,一直到不到 11 GB 的 2-bit 都如此;不过这里的上下文更短,约 4k token。
智能体编码:Terminal-Bench 2.1
Terminal-Bench 2.1 是标准智能体基准,共 89 个任务。我用 3 小时超时、xhigh 推理强度,预留 98k 上下文。BF16 复现了官方结果,Q4KM 也打平(我漏跑了 Q80,但可以在 4-bit 与完整模型之间安全地插值;跑它既贵又没必要)。到 2-bit UD-Q2K_XL 才开始明显下滑,不过仍相当于 Opus 4.7 或 Gemini 3.1 Pro 的水平——远非前沿,但也远非没用。
过程方面,在同一批成功解出的任务里,UD-Q2KXL 和 BF16 的轮次一样,只是多写了约四分之一 token。
1-bit 悬崖
1-bit 质量断崖式下跌。就像之前关于知识影响的测试一样,量化损伤是非线性的:先没有可测变化,接着小幅下降,最后崩溃。2-bit 多少还能用,但最好的 1-bit 模型在这些基准上也约等于随机猜,最小的 UD-IQ1S 甚至低于随机基线。更长的推理反而更糟:xhigh 下的分数低于 low,因为模型常在 token 预算耗尽后返回空答案。Unsloth 声称 UD-IQ1S“保留了约 72% 的 top-1 准确率,体积却小 89%”,但在这里,丢掉的那 28% 关系重大。
成本
跑这些基准不便宜,租 GPU 比 API 还贵。我用 Modal 跑,因为它方便从 CLI 调用。要找到最优运行方式:相比 MTP,我一般开几个并行流,约束是显存必须同时容得下模型和 KV-cache。我用了 NVIDIA L40S(与 RTX 4090 同代 Ada Lovelace 芯片,显存 48 GB)、H100(80 GB)和 H200(141 GB)。相比之下,284B 的 DeepSeek V4 Flash 0731 在 OpenRouter 最便宜供应商处输出约 0.1 美元/Mtok。这个差距有多少来自规模化运行效率、定价策略还是热度,我无法判断。
结论
本地跑实验时,通常选择能装进 GPU、同时满足上下文要求的最好模型。对大多数任务,Unsloth 的 Q4KM 应该够好,不会有可感知的差别;一些更简单的任务,UD-Q2KXL 也完全够用。有人报告 KV-cache 对量化更敏感,我之后可能会再测。整体上,量化该被拥抱,而不是被害怕。
评论
社区对 Qwen3.8 27B 低比特量化模型的实用价值存在分歧,多数人认为 4-bit 附近基准质量损失小但本地硬件速度受限,少数人指出文章统计误用且真实任务对量化更敏感。
认为4-bit量化在基准上质量损失很小
- 论据:terminal-bench显示4-bit匹配全精度,且模型以更高思考预算抵消采样分布偏移,成功率高(较多人) > 低比特下模型靠增加思考时长最终完成任务,成功率与全精度相近(@sharmajai)
质疑文章统计方法与写作质量
- 论据:作者误将置信区间归为运行间噪声,且图表非线性、标签模糊、叙述冗杂,令人怀疑其理解力(较多人) > 置信区间与运行间变化无关,这是常见误解(@spider-mario)
本地消费级硬件运行速度不足或尚不实用
- 论据:旧款笔记本设备跑大模型仅个位数 tok/s,不如调用便宜API或等多年后硬件升级(较多人) > 在旧M1 Max上Qwen3.8速度太低,除非特定本地需求否则不如用便宜模型服务(@bellowsgulch)
真实编码任务对量化精度敏感,反驳“4位前无差异”
- 论据:自创技术基准中仅Q6_XL变体解出,Q5及以下失败,表明常见“跨过4位才感知差异”过于乐观(高赞) > 实际任务里Q6与Q5结果迥异,让我怀疑低比特无差异的共识(@anyfoo)
测试所用量化非标准且需更细粒度对比
- 论据:文中4-bit非均匀量化,不同方案(如NVFP4仅限N卡)速度精度有异;应测模型量化与KV缓存量化组合(较多人) > 这些量化并非均匀,观察未必适用于其他量化(@kouteiheika)
有价值的补充
- 在5060ti上通过Unsloth IQ3_S配合草稿推测等配置,可实现30-50 tok/s生成,证明中端显卡可运行(@zrail)
- 长上下文下KV缓存量化可能比模型量化更关键,需基准揭示不同组合的质量损失(@alentred)
- 低于16GB显存卡的质量拐点仍是测试空白,值得后续填补(@purpleflame1257)